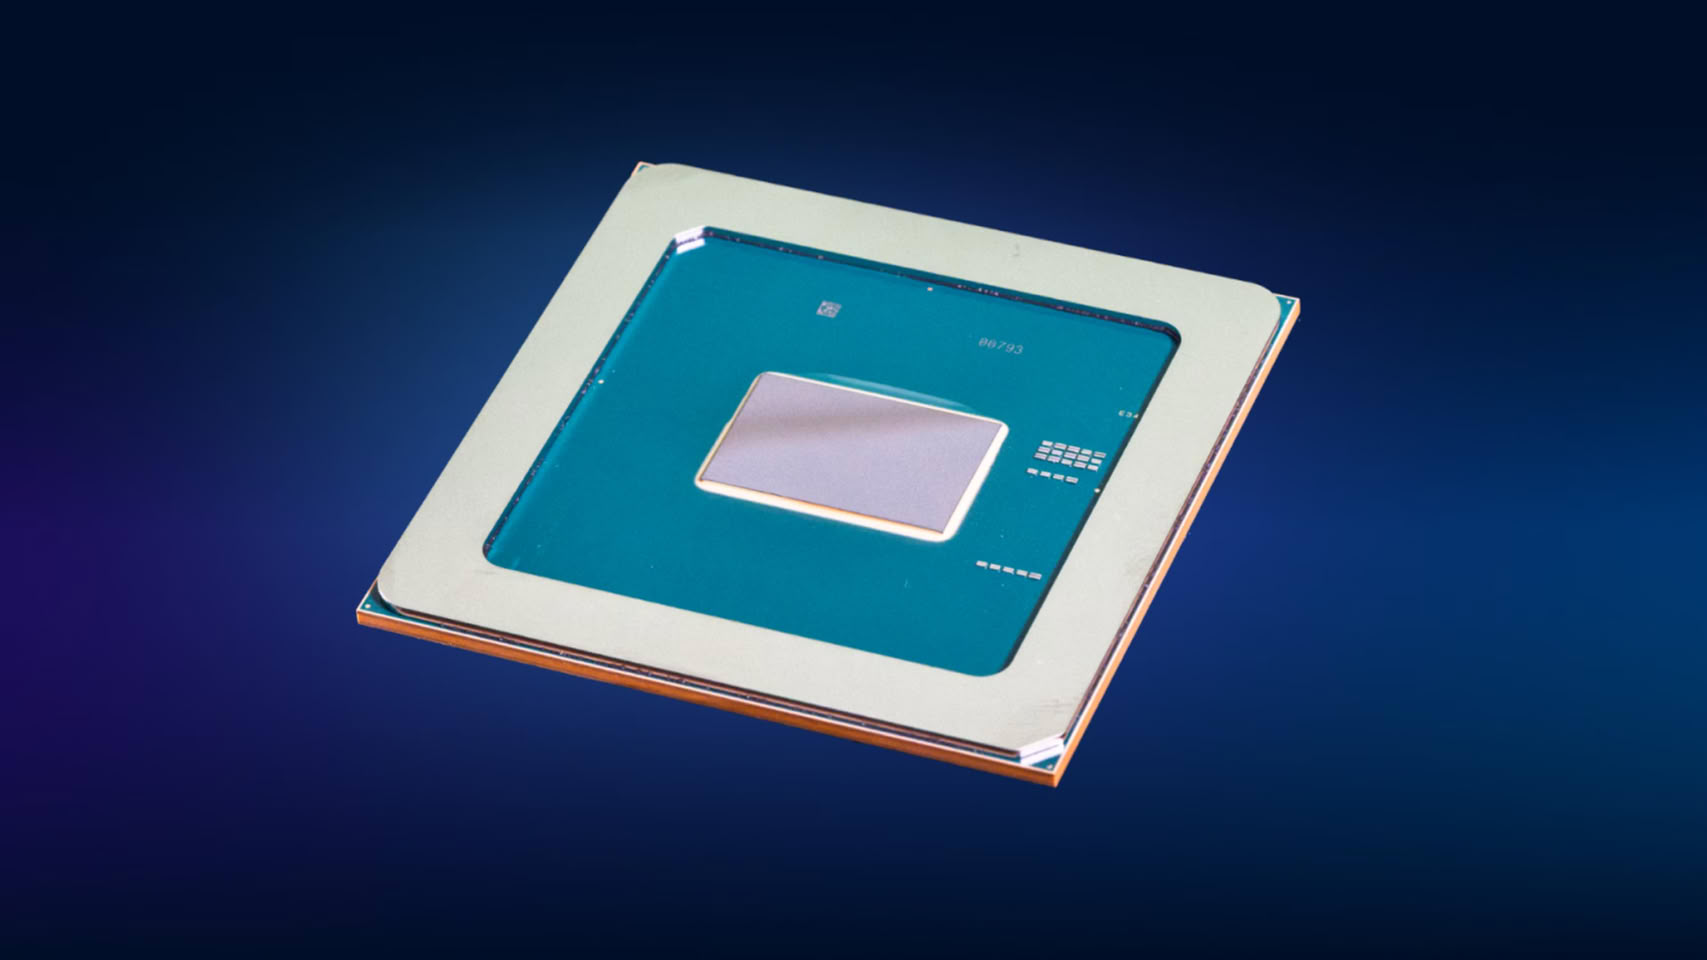
Intel kembali mengungkap detail terbaru mengenai GPU akselerator artificial intelligence (AI) Crescent Island, yang kini dipasarkan dengan nama Intel GPU D-series. Melalui situs resminya, perusahaan memperlihatkan foto fisik chip atau bare die yang digunakan pada model flagship Intel GPU D270, sekaligus memberikan gambaran mengenai desain arsitektur Xe3P yang dikembangkan khusus untuk kebutuhan AI inference.
Berbeda dari GPU konvensional yang dirancang untuk gaming atau rendering grafis, Crescent Island lebih berfokus pada pemrosesan model AI yang telah dilatih, termasuk large language model (LLM), aplikasi berbasis AI agent, serta workload yang membutuhkan context window berukuran besar.
Intel GPU D270 hadir dengan konfigurasi 32 Xe3P core, 256 XMX engine, dan 32 MB unified L2 cache. Akselerator ini juga mendukung memori LPDDR5X hingga 480 GB pada konfigurasi tertentu serta menggunakan antarmuka PCI Express 5.0 x16 dengan konsumsi daya 350 watt.
Menariknya, foto die yang dipublikasikan Intel memperlihatkan desain chip yang relatif ringkas dibandingkan ekspektasi terhadap akselerator AI dengan kapasitas memori sebesar itu.
Hal tersebut mencerminkan pendekatan Intel yang lebih mengutamakan efisiensi arsitektur dan kapasitas memori dibandingkan penggunaan chip berukuran sangat besar seperti yang ditemukan pada sejumlah GPU AI kelas data center.
Intel Crescent Island D270 Gunakan Arsitektur Xe3P Khusus AI
Intel GPU D270 merupakan produk unggulan dalam keluarga GPU D-series yang sebelumnya dikenal dengan codename Crescent Island.
Produk tersebut telah diperkenalkan secara lebih rinci pada Open Compute Project (OCP) Global Summit 2026, ketika Intel mengungkap konfigurasi hardware dan pendekatan arsitektur yang digunakan.
Crescent Island menggunakan mikroarsitektur Xe3P, pengembangan dari arsitektur Xe3 yang telah disesuaikan untuk menangani workload komputasi AI.
Huruf P pada Xe3P merujuk pada pendekatan arsitektur yang lebih berorientasi pada performa komputasi, terutama operasi matematika yang banyak digunakan dalam AI inference.
Berbeda dari GPU gaming, Intel menghilangkan sejumlah komponen yang biasanya digunakan untuk menjalankan pipeline grafis 3D, ray tracing, dan output display.
Ruang pada silicon yang sebelumnya dialokasikan untuk komponen grafis tersebut kemudian digunakan untuk memperkuat kemampuan pemrosesan matrix dan vector.
Pendekatan ini memungkinkan Intel memaksimalkan penggunaan area chip untuk operasi AI yang membutuhkan kemampuan komputasi paralel dalam jumlah besar.
Dengan demikian, meskipun menggunakan istilah GPU, Intel D270 bukan kartu grafis yang dirancang untuk menjalankan game atau menampilkan gambar ke monitor.
Akselerator tersebut sepenuhnya ditujukan untuk lingkungan server dan data center yang menjalankan layanan AI.
Konfigurasi 32 Xe3P Core dan 256 XMX Engine
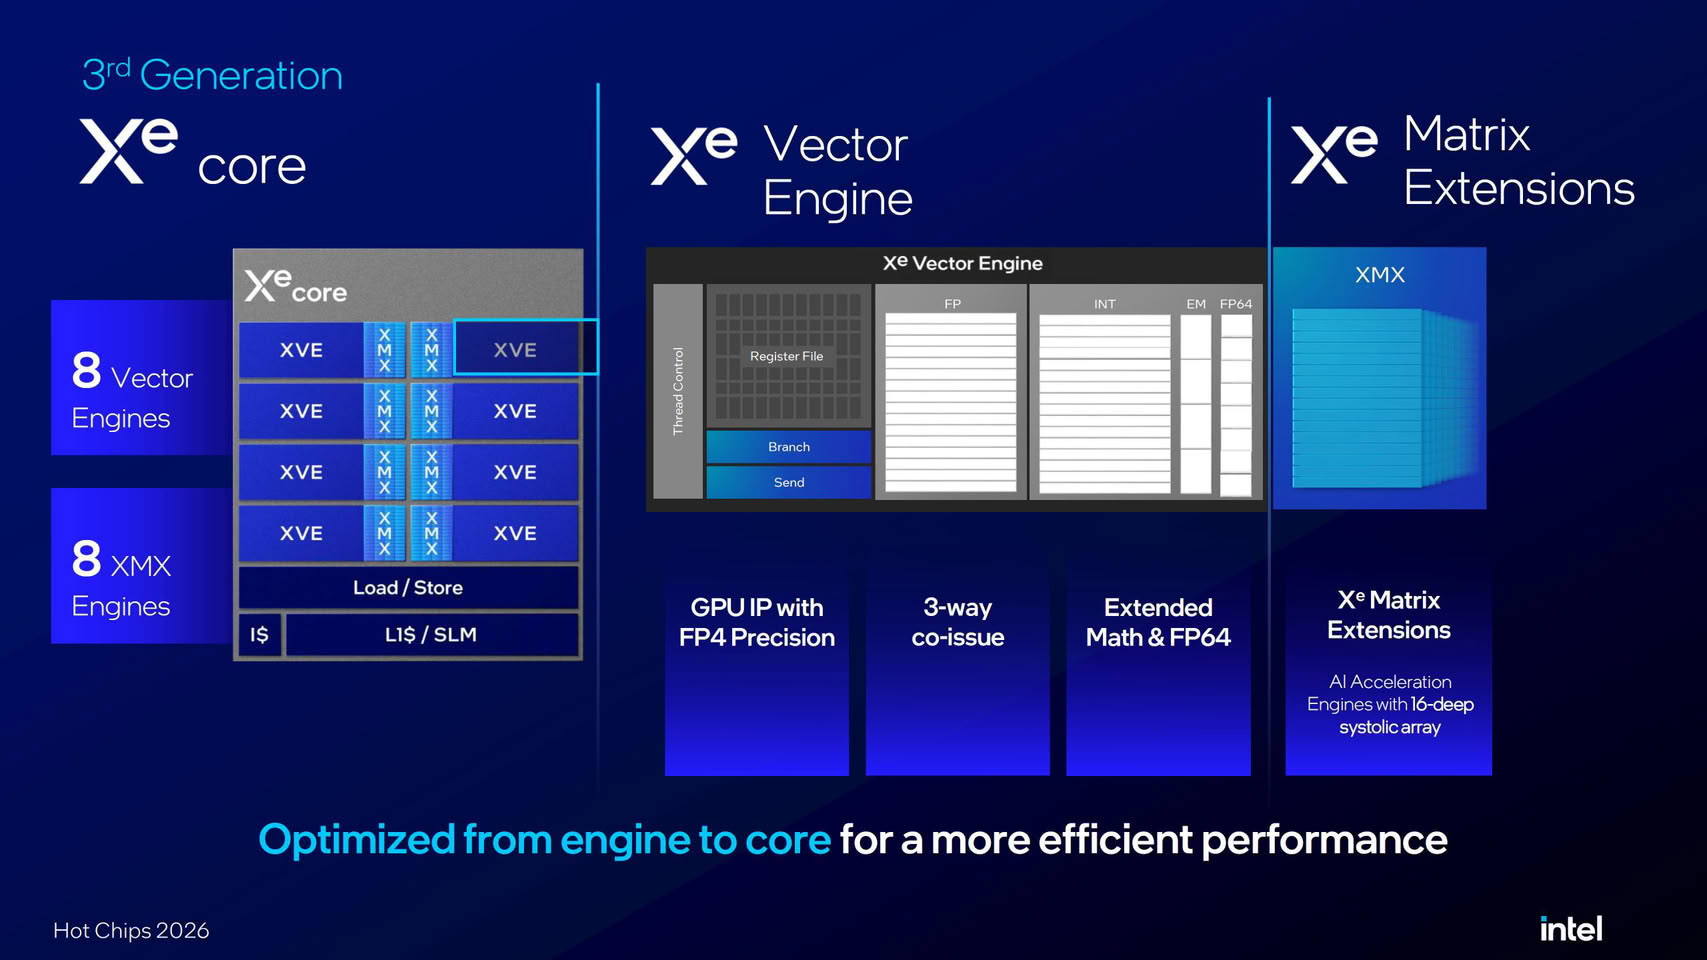
Berdasarkan detail arsitektur yang telah diungkap Intel, GPU D270 menggunakan 32 Xe3P core yang dibagi ke dalam empat kelompok komputasi.
Setiap Xe3P core dilengkapi delapan Vector Engine dan delapan XMX Engine.
Dengan konfigurasi tersebut, keseluruhan chip memiliki 256 Vector Engine dan 256 XMX Engine yang bekerja untuk mempercepat berbagai jenis operasi komputasi.
Vector Engine digunakan untuk menangani operasi komputasi umum, sementara XMX atau Xe Matrix Extensions merupakan unit pemrosesan khusus yang dirancang untuk mempercepat perhitungan matrix.
Operasi matrix menjadi komponen penting dalam neural network karena digunakan secara intensif pada proses inferensi model AI.
Intel juga melakukan perubahan besar terhadap desain XMX Engine pada arsitektur Xe3P.
Jika arsitektur Xe3 sebelumnya menggunakan desain four-deep systolic array, Xe3P kini mengadopsi konfigurasi 16-deep.
Perubahan tersebut memungkinkan setiap XMX Engine menjalankan lebih banyak operasi matrix dalam satu rangkaian pemrosesan.
Secara arsitektural, peningkatan kedalaman systolic array memberikan peluang untuk meningkatkan efisiensi pemanfaatan data ketika menjalankan operasi matematika berulang.
Hal ini sangat relevan untuk workload AI yang secara rutin melakukan operasi matrix multiplication dalam jumlah besar.
Namun, peningkatan kemampuan teoritis tersebut tetap perlu dibuktikan melalui benchmark aplikasi nyata untuk mengetahui pengaruhnya terhadap performa inferensi.
Cache L2 32 MB dengan Register File 1 MB per Core
Selain peningkatan kemampuan komputasi, Intel turut memperbesar kapasitas penyimpanan data internal pada arsitektur Xe3P.
Setiap Xe3P core memiliki register file sebesar 1 MB serta L1 cache berkapasitas 512 KB.
Sementara itu, seluruh GPU menggunakan unified L2 cache sebesar 32 MB yang dapat dimanfaatkan oleh berbagai unit komputasi.
Kapasitas register file yang besar memungkinkan GPU menyimpan lebih banyak data sementara yang diperlukan selama proses komputasi.
Dengan lebih banyak data yang dapat dipertahankan dekat unit pemrosesan, kebutuhan untuk mengakses memori eksternal dapat dikurangi pada sejumlah workload.
Pendekatan tersebut berpotensi meningkatkan efisiensi eksekusi, terutama ketika GPU menjalankan operasi yang membutuhkan akses data berulang.
L1 cache berkapasitas 512 KB per core juga dirancang untuk mendukung pemrosesan data lokal dengan latensi rendah.
Sementara itu, unified L2 cache membantu mengelola pertukaran data antara unit pemrosesan dan subsistem memori LPDDR5X.
Konfigurasi memori internal ini menjadi salah satu bagian penting dari desain Xe3P karena performa AI inference tidak hanya ditentukan oleh jumlah unit komputasi, tetapi juga kecepatan penyediaan data bagi unit-unit tersebut.
Dukung FP4 dan FP8 untuk Efisiensi AI Inference
Intel Crescent Island D270 mendukung berbagai format presisi komputasi, termasuk FP4 dan FP8, yang semakin banyak digunakan dalam pengembangan model AI modern.
FP8 merupakan format floating-point 8-bit yang memungkinkan proses komputasi berjalan dengan kebutuhan memori lebih rendah dibandingkan format presisi tinggi seperti FP16 atau FP32.
Sementara itu, FP4 menggunakan representasi 4-bit yang dapat mengurangi kebutuhan penyimpanan model lebih jauh.
Penggunaan presisi rendah menjadi penting karena model AI berskala besar dapat memiliki ratusan miliar parameter.
Semakin tinggi presisi yang digunakan, semakin besar pula kapasitas memori yang dibutuhkan untuk menyimpan parameter model tersebut.
Dengan dukungan FP4, model yang telah melalui proses quantization dapat dijalankan menggunakan kebutuhan memori lebih rendah.
Namun, penggunaan presisi lebih rendah tetap memerlukan optimasi untuk mempertahankan kualitas output model.
Berdasarkan spesifikasi yang diumumkan Intel, GPU D270 mampu menghasilkan performa komputasi matrix FP8 hingga 1,3 petaflops.
Angka tersebut menggambarkan kemampuan teoritis pemrosesan floating-point pada format FP8, bukan kecepatan menghasilkan token secara langsung.
Performa aktual saat menjalankan LLM akan bergantung pada arsitektur model, ukuran context window, jumlah pengguna yang mengakses layanan secara bersamaan, serta optimasi software inference.
Memori LPDDR5X hingga 480 GB dengan Bandwidth 1,5 TB/s
Salah satu karakteristik utama Intel Crescent Island adalah penggunaan memori LPDDR5X berkapasitas besar.
Berbeda dari sejumlah akselerator AI kelas data center yang menggunakan High Bandwidth Memory (HBM), Intel memilih LPDDR5X sebagai solusi untuk menyeimbangkan kapasitas memori, konsumsi daya, dan biaya sistem.
Untuk kartu referensi Intel GPU D270, perusahaan menggunakan kapasitas 160 GB LPDDR5X.
Namun, Intel juga memungkinkan mitra Original Design Manufacturer (ODM) mengembangkan kartu dengan kapasitas memori hingga 480 GB LPDDR5X.
Perbedaan tersebut penting karena angka 480 GB bukan merupakan kapasitas standar seluruh kartu Intel D270.
Intel mengklaim subsistem memori akselerator ini mampu menyediakan bandwidth hingga 1,5 TB/s.
Meskipun bandwidth tersebut berada di bawah sejumlah GPU AI yang menggunakan HBM generasi terbaru, Intel menilai LPDDR5X dapat menjadi alternatif yang lebih ekonomis untuk workload inference tertentu.
Kapasitas memori besar memungkinkan lebih banyak parameter model dan data context disimpan langsung pada akselerator.
Hal ini berpotensi mengurangi kebutuhan pemindahan data antara GPU dan memori sistem yang memiliki latensi lebih tinggi.
Untuk aplikasi AI agent, kapasitas memori juga berperan dalam penyimpanan KV cache yang digunakan selama proses inferensi.
Semakin panjang konteks percakapan atau semakin banyak sesi yang dijalankan secara bersamaan, semakin besar kebutuhan memori untuk mempertahankan data tersebut.
Dirancang untuk AI Agent dengan Context Window 100.000 Token
Intel secara khusus mengembangkan Crescent Island untuk menghadapi perubahan pola penggunaan AI yang semakin bergeser menuju sistem agentic.
Berbeda dari chatbot yang hanya menjawab satu pertanyaan, AI agent dapat menjalankan rangkaian tugas kompleks melalui banyak tahapan.
Dalam satu workflow, AI agent mungkin perlu membaca dokumen, mengambil informasi tambahan, menjalankan tools, melakukan analisis, kemudian memproses hasilnya sebelum menghasilkan respons akhir.
Setiap tahapan tersebut dapat melibatkan pemanggilan model AI secara berulang.
Intel menggambarkan skenario penggunaan dengan ribuan langkah pemrosesan, context window sekitar 100.000 token, dan puluhan sesi aktif secara bersamaan.
Kondisi tersebut menghasilkan kebutuhan komputasi dan memori yang berbeda dibandingkan layanan inferensi sederhana.
Salah satu tantangannya adalah mempertahankan context dalam memori agar model tidak harus memproses ulang seluruh informasi ketika berpindah tahapan.
Melalui kapasitas LPDDR5X yang besar, Intel D270 dirancang untuk mempertahankan lebih banyak model dan context secara lokal.
Hal tersebut berpotensi meningkatkan efisiensi proses prefill, yaitu tahap ketika model AI memproses prompt dan informasi konteks sebelum mulai menghasilkan token.
Intel juga menekankan efisiensi token serving, terutama ketika banyak pengguna atau AI agent mengakses model secara bersamaan.
Namun, peningkatan kemampuan tersebut belum dapat dinilai secara menyeluruh karena Intel belum memublikasikan benchmark independen yang memperlihatkan performa D270 pada berbagai framework dan model AI.
Satu GPU Diklaim Bisa Jalankan Model AI 300 Miliar Parameter
Selain mendukung context window berukuran besar, Intel menyatakan keluarga GPU D-series mampu menangani model AI dengan jumlah parameter yang sangat tinggi.
Menurut perusahaan, satu kartu dapat mendukung model dengan kapasitas hingga 300 miliar parameter, sedangkan konfigurasi delapan GPU dapat menangani model yang melampaui satu triliun parameter.
Kemampuan tersebut berkaitan erat dengan konfigurasi kapasitas memori dan metode quantization yang digunakan.
Sebagai ilustrasi, model dengan 300 miliar parameter yang disimpan menggunakan FP8 secara teoritis membutuhkan sekitar 300 GB hanya untuk parameter model, belum termasuk kebutuhan KV cache dan overhead runtime.
Dengan demikian, implementasi model sebesar itu pada satu kartu akan bergantung pada kapasitas memori yang tersedia serta format representasi parameter.
Konfigurasi 480 GB dari mitra ODM menyediakan ruang memori lebih besar dibandingkan kartu referensi Intel berkapasitas 160 GB.
Sementara itu, penggunaan format FP4 dapat membantu mengurangi kebutuhan memori, tetapi tetap harus mempertimbangkan kualitas model dan kebutuhan memori tambahan.
Klaim dukungan model hingga 300 miliar parameter tidak otomatis berarti seluruh model dengan ukuran tersebut dapat dijalankan pada performa optimal.
Performa aktual masih bergantung pada karakteristik model, precision, ukuran context, dan jumlah permintaan yang diproses secara bersamaan.
Media Engine dengan Empat Encoder dan Empat Decoder
Meskipun Intel menghilangkan pipeline grafis konvensional, Crescent Island tetap dilengkapi media engine khusus.
GPU D270 memiliki empat unit encoder dan empat unit decoder yang dapat digunakan untuk membantu pemrosesan video.
Keberadaan media engine ini menjadi penting karena workload AI semakin berkembang menuju pemrosesan multimodal.
Model multimodal tidak hanya menerima input berupa teks, tetapi juga dapat memproses gambar, video, audio, dan berbagai format data lainnya.
Dalam aplikasi video understanding, misalnya, sistem perlu melakukan decoding terhadap stream video sebelum frame dapat dianalisis oleh model AI.
Sementara itu, pada aplikasi generative AI tertentu, proses encoding dapat digunakan untuk menghasilkan file video yang siap disimpan atau didistribusikan.
Dengan media engine khusus, sebagian pekerjaan pemrosesan video dapat ditangani tanpa sepenuhnya membebani unit komputasi utama.
Hal ini dapat membantu meningkatkan efisiensi sistem ketika menjalankan layanan AI yang menggabungkan pemrosesan teks dan video.
Namun, keberadaan media engine tersebut tidak menjadikan D270 sebagai GPU gaming karena chip ini tetap tidak memiliki pipeline grafis lengkap seperti kartu grafis konsumen.
Konsumsi Daya 350 Watt dengan PCI Express 5.0 x16
Dari sisi implementasi hardware, Intel merancang GPU D270 dalam bentuk kartu akselerator PCI Express 5.0 x16 dengan konsumsi daya 350 watt.
Kartu ini menggunakan sistem pendinginan udara, sehingga tidak memerlukan infrastruktur liquid cooling khusus seperti yang digunakan pada sebagian akselerator AI berdaya sangat tinggi.
Pendekatan tersebut ditujukan untuk mempermudah integrasi ke dalam lingkungan server yang sudah menggunakan sistem pendinginan udara konvensional.
Bagi operator data center, kompatibilitas dengan infrastruktur yang tersedia dapat menjadi pertimbangan penting karena penerapan sistem liquid cooling membutuhkan investasi tambahan.
Dengan power envelope 350 watt, satu server yang menggunakan delapan kartu D270 membutuhkan alokasi daya hingga 2.800 watt hanya untuk GPU, belum termasuk CPU, memori sistem, storage, perangkat jaringan, dan komponen pendukung lainnya.
Karena itu, kompatibilitas dengan server tetap harus mempertimbangkan kapasitas power supply, jumlah slot PCIe, ruang fisik, serta kemampuan sistem pendinginan chassis.
Intel menekankan bahwa D270 dirancang menggunakan form factor standar untuk memudahkan proses integrasi tanpa harus membangun infrastruktur server khusus dari awal.
Intel Siapkan Dukungan Software untuk PyTorch dan vLLM
Selain arsitektur hardware, Intel juga menyiapkan ekosistem software untuk mendukung penggunaan GPU D-series pada berbagai workload AI.
Perusahaan mengembangkan akselerator ini dengan fondasi software Xe yang digunakan pada berbagai produk GPU Intel.
Pendekatan tersebut bertujuan mempermudah portabilitas aplikasi dan mengurangi kebutuhan penyesuaian besar ketika developer memindahkan workload ke platform baru.
Intel menargetkan dukungan terhadap framework AI populer, termasuk PyTorch dan vLLM, serta berbagai komponen software open-source yang digunakan untuk menjalankan model AI.
vLLM sendiri merupakan inference engine yang banyak digunakan untuk menjalankan large language model dengan optimasi penggunaan memori dan throughput.
Dukungan terhadap framework tersebut menjadi penting karena keberhasilan akselerator AI tidak hanya bergantung pada performa hardware.
Ketersediaan driver, library komputasi, compiler, dan integrasi dengan inference engine turut menentukan apakah suatu GPU dapat digunakan secara efisien dalam lingkungan produksi.
Intel juga menargetkan kompatibilitas dengan model AI open-source agar pengguna memiliki lebih banyak pilihan dalam membangun infrastruktur inference.
Intel Crescent Island D270 Belum Memiliki Benchmark Independen
Meskipun spesifikasi teknis Crescent Island D270 semakin lengkap, masih terdapat sejumlah informasi penting yang belum diumumkan Intel.
Perusahaan belum mengungkapkan harga resmi maupun jadwal ketersediaan komersial GPU D-series secara luas.
Intel telah mengonfirmasi bahwa proses distribusi sampel kepada pelanggan sedang berlangsung, tetapi belum memberikan tanggal pasti untuk peluncuran produk secara umum.
Hingga saat ini, belum tersedia benchmark independen yang dapat digunakan untuk membandingkan performa Intel D270 dengan akselerator AI dari NVIDIA maupun AMD.
Informasi mengenai throughput token, latensi inference, efisiensi penggunaan memori, dan konsumsi daya aktual masih diperlukan untuk menilai posisi kompetitif produk tersebut.
Selain itu, aspek biaya operasional menjadi salah satu faktor penentu dalam penggunaan GPU AI di data center.
Akselerator dengan konsumsi daya lebih rendah belum tentu menawarkan biaya pemrosesan token yang lebih baik apabila throughput aktual atau efisiensi software belum optimal.
Karena itu, evaluasi terhadap Intel D270 masih perlu menunggu hasil pengujian menggunakan workload produksi, terutama model LLM dengan context panjang dan tingkat concurrency tinggi.
Crescent Island Jadi Strategi Intel di Pasar AI Inference
Kemunculan foto die Intel Crescent Island D270 memberikan gambaran tambahan mengenai pendekatan perusahaan dalam mengembangkan akselerator AI.
Alih-alih mengejar desain chip dengan kemampuan komputasi terbesar, Intel memilih mengoptimalkan arsitektur Xe3P untuk kebutuhan inference yang membutuhkan kapasitas memori besar dan konsumsi daya terkontrol.
Konfigurasi 32 Xe3P core, 256 XMX Engine, 32 MB unified L2 cache, serta dukungan hingga 480 GB LPDDR5X menunjukkan fokus tersebut.
Keputusan menggunakan LPDDR5X juga memperlihatkan upaya Intel menawarkan alternatif terhadap akselerator berbasis HBM yang banyak digunakan dalam sistem AI kelas atas.
Bagi perusahaan dan penyedia cloud yang ingin menjalankan model AI secara lokal, kemampuan menggunakan kartu PCIe 5.0 dengan pendinginan udara dapat menjadi pertimbangan menarik.
Namun, daya tarik tersebut masih harus dibuktikan melalui pengujian performa dan biaya implementasi aktual.
Dengan semakin berkembangnya aplikasi agentic AI dan kebutuhan memproses context window yang panjang, Intel D270 diposisikan sebagai solusi untuk meningkatkan kapasitas inference tanpa harus selalu beralih ke infrastruktur berdaya sangat tinggi.
Keberhasilan strategi tersebut pada akhirnya akan bergantung pada harga, kematangan ekosistem software, serta kemampuan GPU D-series mempertahankan performa ketika menangani workload AI di lingkungan produksi.
Sumber: Intel GPU D270 – Inference-Optimized Data Center GPU